
En el PID se incluye un campo de nombre y otro de apellido, pero no se contempla un tratamiento de nombres compuestos españoles y de dos apellidos, que pueden ser tambien compuestos (los 2 apellidos).
Y es que hay que reconocer que la costumbre anglosajona de usar un único campo de apellido no encaja con la costumbre española, y nuestra preferencia «rasca» con la forma en que se regula el PID. Así que propongo en este artículo una forma de codificar y decodificar la estructura del nombre y los dos apellidos sin romper la interoperabilidad, y sugiero una propuesta de cómo debería evolucionar la descripción del PID en el «Rule Book» para que la cartera europea sea directamente usable en España.
Para la solución provisional me baso en la solución adoptada para las menciones científicas de autores hispanos en publicaciones internacionales,
El problema de fondo
El modelo de datos de identificación de persona —el PID (Person Identification Data)— hereda, como casi todos los esquemas de identidad de origen anglosajón, una simplificación de partida: un campo para el nombre y un campo para el apellido. En concreto, el PID ofrece given_name (obligatorio, con los nombres intermedios incluidos), family_name (obligatorio), y opcionalmente given_name_birth y family_name_birth. Todos son cadenas de texto libre, sin subestructura.
Ese diseño encaja mal con la costumbre española, que descansa sobre dos rasgos que el campo único no sabe representar.
Primero, los dos apellidos. Un ciudadano español tiene primer y segundo apellido, y desde las reformas del Registro Civil su orden ya no es necesariamente el paterno-primero: los progenitores lo eligen y la persona adulta puede invertirlo. Por tanto, cualquier convención que hable de «apellido paterno» y «apellido materno» nace equivocada; lo correcto es hablar de primer y segundo apellido como posiciones, no como linaje.
Segundo, los componentes compuestos. Tanto el nombre de pila (José María, María del Carmen, Juan Carlos) como cada apellido pueden ser internamente compuestos: con partículas (García de la Torre, Fernández de Córdoba, del Río), con la conjunción copulativa (Ramón y Cajal, Martí i Franquès) o con guion (Sánchez-Cano).
La consecuencia es que, cuando toda esa riqueza se aplasta en family_name = "García de la Torre Martín", la cadena deja de ser decodificable sin ambigüedad: ¿es «García de la Torre» + «Martín», o «García» + «de la Torre Martín»? El espacio, que es el separador natural del texto, no distingue el hueco entre los dos apellidos del hueco interno de un apellido compuesto. Es exactamente el mismo fenómeno que llevó a la comunidad científica a normalizar la firma para que las bases de datos no descompusieran «García Pérez» en «Pérez, G.».
Dónde se regula el PID: actos de ejecución y ARF
Antes de proseguir con la propuesta conviene situar las piezas normativas, porque el PID no se regula en un solo texto. En el plano de los actos de ejecución del Reglamento eIDAS 2, el que define los atributos del PID —obligatorios y opcionales— y su ciclo de vida es el Reglamento de Ejecución (UE) 2024/2977, de 28 de noviembre de 2024, sobre datos de identificación de la persona y declaraciones electrónicas de atributos. Lo acompañan, en la misma tanda, el 2024/2979 (integridad y funcionalidades esenciales de la cartera), el 2024/2980 (notificaciones al ecosistema), el 2024/2981 (certificación de las carteras) y el 2024/2982 (protocolos e interfaces, es decir, el catálogo de estándares con los que el PID se emite y se presenta). La segunda serie, de 2025, lo roza de forma indirecta pero muy pertinente para este asunto —el 2025/846 regula el cross-border identity matching, el cotejo transfronterizo en el que la estructura del nombre es justamente lo que se compara—, y en 2026 se han publicado enmiendas (que ya he mencionado en el blog) que tocan los actos nucleares, incluido el 2024/2977, por lo que conviene trabajar siempre sobre el texto consolidado.
En el plano técnico, el Architecture and Reference Framework (ARF, cuya ultima versión en este momento es la 3.0) desarrolla lo anterior en varias piezas: el documento principal; el Annex 1 (Definiciones); el Annex 2 (High-Level Requirements), con requisitos técnicos, algunos específicos del PID; y, sobre todo, el Annex 3.01 – PID Rulebook, que es donde se define el esquema de atributos y sus dos codificaciones, mdoc (ISO/IEC 18013-5) y SD-JWT VC. Como referencia paralela está el Annex 3.02 (mDL Rulebook), y para el ciclo completo, el Annex 4 (emisión y presentación) y el Annex 6 (certificación). Cuando en este artículo se habla de «evolucionar la descripción del PID», el objeto concreto es el Annex 3.01 y el anexo del Reglamento 2024/2977.
Esta es la relación de actos de ejecución, con indicación de cuáles inciden en el PID (los números enlazan al texto en EUR-Lex):
| Acto de ejecución | Objeto | Incidencia en el PID |
|---|---|---|
| (UE) 2024/2977 | Datos de identificación de la persona y declaraciones electrónicas de atributos | Define el PID (atributos y ciclo de vida) |
| (UE) 2024/2979 | Integridad y funcionalidades esenciales de la cartera | Indirecta |
| (UE) 2024/2980 | Notificaciones a la Comisión sobre el ecosistema | Indirecta |
| (UE) 2024/2981 | Certificación de las carteras | Indirecta |
| (UE) 2024/2982 | Protocolos e interfaces (estándares de referencia) | Formatos de emisión y presentación |
| (UE) 2025/846 | Cotejo transfronterizo de identidades | Relevante: coteja nombre y apellidos |
| (UE) 2025/847 | Notificación de brechas de seguridad | Indirecta |
| (UE) 2025/848 | Registro de las partes usuarias | Indirecta |
| (UE) 2025/849 | Lista de carteras certificadas | Indirecta |
| (UE) 2025/2162 | Acreditación de los organismos de evaluación de la conformidad | Indirecta |
| (UE) 2026/1731 | Enmienda a 2024/2977, 2024/2979, 2024/2980 y 2024/2982 (estándares y especificaciones) | Modifica el 2024/2977 |
Qué exige el Reglamento sobre estos campos
El Reglamento 2024/2977 define family_name y given_name como texto libre destinado a mostrar y cotejar la identidad; es decir, como el valor legible que una parte usuaria (relying party) enseñará a un operador o comparará con otro documento. Esto impone una restricción de diseño ineludible: el valor de presentación debe seguir siendo la forma natural del nombre. No podemos contaminarlo con marcadores estructurales, porque una parte usuaria de otro Estado miembro que no conozca nuestra convención mostraría un artefacto con símbolos a un funcionario.
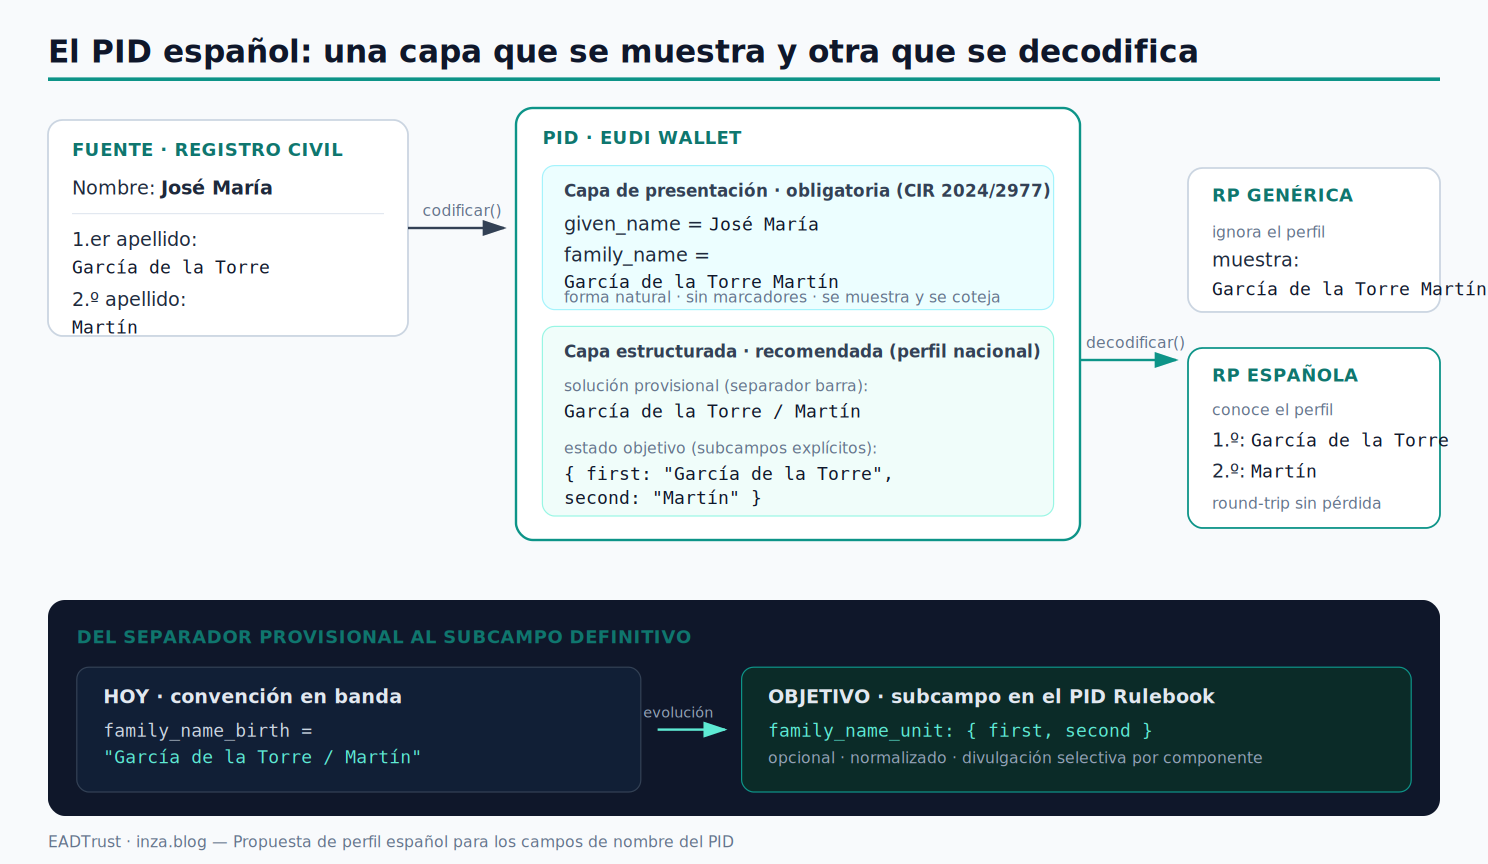
De aquí se deriva el principio rector de toda esta propuesta: separar el valor de presentación del valor estructurado. La estructura interna del nombre no debe viajar dentro del campo obligatorio de display, sino en un canal que degrade con elegancia: los campos opcionales o —mejor— un subcampo estructurado en el propio Rulebook.
Qué le pedimos a una solución provisional
Mientras el esquema del PID no incorpore subcampos de nombre, necesitamos una convención que preserve la estructura dentro de los campos que hoy existen. Para que sea sólida, esa convención debe cumplir cinco requisitos:
- Reversibilidad.
codificar(decodificar(x)) == x. La estructura recuperada debe volver a producir exactamente la misma cadena, sin pérdida. - Seguridad de presentación (degradación elegante). Si un sistema ignora la convención, lo que muestre debe seguir siendo un nombre legible, no un artefacto.
- Seguridad de codificación. El PID se serializa en CBOR/COSE (formato mdoc, ISO/IEC 18013-5) o en JSON (SD-JWT VC). El marcador elegido no debe crear peligros de escape ni de doble escape al atravesar esas capas, ni al pasar por LDAP, expresiones regulares o URLs.
- No colisión con caracteres legítimos del nombre. El marcador no puede ser un carácter que aparezca de forma natural en nombres españoles (ni el espacio, ni el guion, ni el punto, ni la conjunción «y/i»).
- Neutralidad respecto al orden. La convención codifica posición (primer/segundo apellido), nunca linaje.
La solución provisional: la barra inclinada
El carácter que satisface esos cinco requisitos es la barra inclinada (/). Es legal sin escape dentro de una cadena JSON y es un byte ordinario en CBOR, de modo que sobrevive intacta a ambas serializaciones y a su conversión mutua. No aparece nunca en nombres españoles, así que no colisiona con ningún componente legítimo. Y, si un sistema que desconoce la convención la muestra tal cual, produce «García de la Torre / Martín», que cualquier persona interpreta sin dificultad: degrada de forma legible en lugar de romperse.
La propuesta es, por tanto, un modelo de dos capas. La capa de presentación usa los campos obligatorios tal cual los concibe el Reglamento, con la forma natural y sin ningún marcador. La capa estructurada transporta la descomposición reversible: mientras el Rulebook no ofrezca subcampos, se codifica en banda —por ejemplo en family_name_birth o en un atributo nacional— con la barra separando solo el primer y el segundo apellido, y preservando cada componente con sus propios espacios, partículas y guiones.
El algoritmo es trivial y auditable. Estas son las reglas, con la normalización Unicode a NFC incluida y el escape por porcentaje para la —rarísima— barra literal dentro de un componente:
# Marcador y escapeSEP = " / "esc(c) = c.replace("%","%25").replace("/","%2F")unesc(c) = c.replace("%2F","/").replace("%25","%")codificar(primer, segundo): primer, segundo = NFC(primer), NFC(segundo) if segundo == "": return esc(primer) # apellido único return esc(primer) + SEP + esc(segundo)decodificar(s): partes = NFC(s).split(SEP) if len(partes) == 1: return (unesc(partes[0]), "") return (unesc(partes[0]), unesc(SEP.join(partes[1:])))
Casos límite, resueltos
- Apellido único (extranjeros nacionalizados, o españoles con un solo apellido): ausencia de barra.
"Smith"se codifica como"Smith"y la decodificación devuelve segundo apellido vacío. El round-trip se mantiene. - Conjunción copulativa. Ramón y Cajal o Martí i Franquès pueden ser un único apellido compuesto. La barra es la única frontera autoritativa; el «y»/«i» nunca lo es. Así,
"Ramón y Cajal / Ferrer"se decodifica sin ambigüedad como primer apellido «Ramón y Cajal» y segundo «Ferrer». - Barra literal en un nombre (excepcional): se codifica por porcentaje (
%2F), de modo que el separador nunca se confunde con un carácter del propio nombre. - Normalización Unicode. Todo componente se normaliza a NFC y se conserva el uso registral de mayúsculas y minúsculas (partículas «de», «de la», «del» en minúscula cuando no encabezan). Sin esto, el cotejo posterior falla por diferencias de composición de las tildes.
En este contexto NFC es Normalization Form C (Forma de Normalización C, o «composición canónica»).
Todas estas reglas están verificadas con round-trip automático sobre los cuatro casos —compuesto con partículas, apellido único, conjunción copulativa y barra literal— antes de escribir una sola línea del ejemplo que sigue.
Ejemplo completo
Tomemos una persona por su estructura: nombre de pila compuesto, primer apellido con partículas y segundo apellido simple.
| Elemento | Valor |
|---|---|
| Nombre de pila | José María |
| Primer apellido | García de la Torre |
| Segundo apellido | Martín |
family_name (presentación) | García de la Torre Martín |
| Forma estructurada (barra) | García de la Torre / Martín |
Un detalle que conviene tener presente en cualquier codificación binaria: «García de la Torre Martín» ocupa 27 bytes en UTF-8 pero solo 25 caracteres, porque cada «í» son dos bytes (0xC3 0xAD). Las longitudes que aparecen en el CBOR de abajo son de bytes, no de caracteres.
(A) Formato mdoc — ISO/IEC 18013-5 (CBOR)
En el namespace eu.europa.ec.eudi.pid.1, los atributos del PID se serializan como un mapa CBOR. Esta es la representación del ejemplo en notación diagnóstica:
{ "given_name": "José María", "family_name": "García de la Torre Martín", "birth_date": 1004("1978-05-14"), / tag full-date / "birth_place": "ES", "nationality": ["ES"], "family_name_birth": "García de la Torre Martín", "issuing_country": "ES", "issuing_authority": "Ministerio del Interior"}
Y su codificación real, byte a byte (hex), 230 bytes en total:
a8 # map(8) 6a 676976656e5f6e616d65 # "given_name" 6c 4a6f73c3a9204d6172c3ad61 # "José María" 6b 66616d696c795f6e616d65 # "family_name" 78 1b 47617263c3ad61206465206c6120 # text(27) "García de la 546f727265204d617274c3ad6e # Torre Martín" 6a 62697274685f64617465 d9 03ec # "birth_date" tag(1004) 6a 313937382d30352d3134 # "1978-05-14" 6b 62697274685f706c616365 62 4553 # "birth_place" "ES" 6b 6e6174696f6e616c697479 81 62 4553 # "nationality" ["ES"] 71 66616d696c795f6e616d655f6269727468 # "family_name_birth" 78 1b 47617263c3ad61...c3ad6e # text(27) "García…Martín" 6f 69737375696e675f636f756e747279 62 4553 # "issuing_country" "ES" 71 69737375696e675f617574686f72697479 # "issuing_authority" 77 4d696e6973746572696f2064656c20496e... # "Ministerio del Interior"
Cada atributo se firma, en realidad, dentro de un IssuerSignedItem envuelto en un byte string marcado con la etiqueta CBOR 24 (encoded-cbor). Para family_name:
# Tag 24 > bstr > { digestID, random, elementIdentifier, elementValue }d818 5863 a4 68 646967657374494403 # "digestID": 3 66 72616e646f6d 48 8f9b6c2d1e4a7f30 # "random": h'8f9b…7f30' 71 656c656d656e744964656e746966696572 # "elementIdentifier" 6b 66616d696c795f6e616d65 # "family_name" 6c 656c656d656e7456616c7565 # "elementValue" 78 1b 47617263c3ad61...546f727265204d617274c3ad6e # "García de la Torre Martín"
La forma estructurada en mdoc. El atributo family_name mantiene la forma natural; la descomposición viaja aparte, en un elemento propuesto family_name_unit, como submapa CBOR —limpio, sin marcadores en banda y con divulgación selectiva independiente:
a1 70 66616d696c795f6e616d655f756e6974 # { "family_name_unit": a2 65 6669727374 73 47617263c3ad612064... # "first": "García de la Torre", 66 7365636f6e64 67 4d617274c3ad6e # "second": "Martín" } }
(B) Formato SD-JWT VC (JSON con divulgación selectiva)
En SD-JWT VC cada atributo divulgable se materializa en una disclosure —base64url([salt, nombre, valor])— cuyo digest SHA-256 se referencia en el array _sd del payload. Las disclosures del ejemplo (incluida la estructurada) son:
# family_nameWyIyR0xDNDJzS1F2ZUNmR2ZyeU5STjl3IiwiZmFtaWx5X25hbWUiLCJHYXJjw61hIGRlIGxhIFRvcnJlIE1hcnTDrW4iXQ # [ "2GLC42sKQveCfGfryNRN9w", "family_name", # "García de la Torre Martín" ]# family_name_unit (estructura, divulgable por separado)WyI2SWo3dE0tYTVpVlBHYm9TNXRtdlZBIiwiZmFtaWx5X25hbWVfdW5pdCIseyJmaXJzdCI6IkdhcmPDrWEgZGUgbGEgVG9ycmUiLCJzZWNvbmQiOiJNYXJ0w61uIn1d # [ "6Ij7tM-a5iVPGboS5tmvVA", "family_name_unit", # { "first": "García de la Torre", "second": "Martín" } ]
// payload del JWT{ "vct": "urn:eudi:pid:1", "iss": "https://pid-provider.eadtrust.example", "iat": 1789000000, "_sd_alg": "sha-256", "_sd": [ "yfz5UHtG2F_rLi1yy91D4jhgTp4E1Drr622DHtTg2h0", // family_name "fXAlOjDoJjc5bDmf-t2dbtV1I3sQ85dfQqPXQVQGYPc", // given_name "6b1YOIoO3h9rWMav2ohyH6ngyJOmWnjqx682KF_FInk" // family_name_unit ]}
La ventaja del submapa family_name_unit como disclosure propia es doble: la parte usuaria española que necesite el primer apellido para un cotejo registral puede pedirlo sin forzar la revelación del segundo, y la parte usuaria genérica sigue recibiendo family_name tal cual, sin enterarse de la estructura. Divulgación selectiva y degradación elegante en el mismo mecanismo.
(C) Formato W3C Verifiable Credentials (JSON-LD), como referencia
Donde se use el perfil W3C VC, la misma idea se expresa con un objeto anidado en credentialSubject, conservando el literal de presentación junto a la estructura:
"credentialSubject": { "given_name": "José María", "family_name": "García de la Torre Martín", "family_name_unit": { "first": "García de la Torre", "second": "Martín" }}
Por qué la solución robusta no está en el separador
Es una humilde propuesta para resolver el problema, pero no es la panacea. Igual que en la firma de publicaciones científicas la normalización tipográfica acabó siendo un paliativo y la respuesta estructural fue el identificador persistente (ORCID), aquí el separador en banda es una solución de compromiso para cuando no hay más remedio. La respuesta arquitectónicamente correcta es que la estructura del nombre la conoce el registro emisor —el PID Provider parte del Registro Civil, que sí distingue primer y segundo apellido— y que esa estructura se transporte en subcampos explícitos, no incrustada en una cadena de texto que otros sistemas cotejarán a ciegas. La barra nos salva mientras tanto; el subcampo nos salva para siempre.
Cómo debería evolucionar la descripción del PID
El caso español no es una excepción folclórica: Portugal encadena hasta cuatro apellidos, los países árabes construyen cadenas patronímicas, Islandia usa patronímicos en lugar de apellido de familia. Un modelo de nombre que solo contempla «nombre + apellido» es, en realidad, un problema paneuropeo que España evidencia con especial claridad. Estas son las evoluciones que, a mi juicio, deberían incorporar el Annex 3.01 (PID Rulebook) y el anexo del Reglamento 2024/2977:
- Un atributo de nombre estructurado, opcional y normalizado. Añadir al esquema PID un
family_name_unit(submapafirst/second, ampliable athird/fourthpara Portugal) y ungiven_name_unitcon el nombre habitual marcado. Opcional, para no romper a nadie; estructurado, para no perder información. - Posición, no linaje. Nombrar los componentes por orden (
first,second) y nunca por origen (paterno/materno), en coherencia con la libre elección y la inversión del orden que permite la ley española. - Divulgación selectiva por componente. Que cada subcomponente sea una claim divulgable de forma independiente, de modo que una parte usuaria pueda solicitar solo el primer apellido cuando es lo que necesita para un cotejo, minimizando datos.
- Reglas de normalización explícitas en el propio Rulebook. Fijar NFC obligatorio, tratamiento de mayúsculas/minúsculas de partículas y —para el escenario provisional en banda— la barra como separador con escape por porcentaje. Escrito en la norma, no dejado al criterio de cada emisor.
- Un anexo nacional (perfil español del PID). El mecanismo por el que el ARF admite perfiles y rulebooks de atributos debería acoger un anexo español que registre formalmente esta convención, del mismo modo que ya existen rulebooks para otros dominios de atributos.
- Coherencia con el cotejo transfronterizo. El acto de ejecución 2025/846 sobre identity matching se apoya precisamente en el nombre y los apellidos; un PID con nombre estructurado hace ese cotejo fiable y evita repetir en la cartera los apaños ad hoc que cada nodo nacional viene arrastrando desde el conjunto mínimo de datos de eIDAS SAML.
Conclusión
El PID no fue diseñado pensando en los dos apellidos ni en los compuestos con partículas, y el campo único de texto libre es, para el caso español, estructuralmente insuficiente. La vía sensata no es maltratar el campo obligatorio de presentación —que debe seguir mostrando el nombre natural—, sino separar presentación de estructura, adoptar mientras tanto un separador que sobreviva a CBOR, JSON, LDAP y a las expresiones regulares —la barra inclinada, con sus reglas de frontera reversibles—, y, sobre todo, promover que el Annex 3.01 y el Reglamento 2024/2977 incorporen la estructura del nombre como subcampo explícito. Mientras Europa no lo haga, cada emisor español lo resolverá a su manera; y la interoperabilidad, que es justo lo que la EUDI Wallet viene a traer, se resentirá precisamente en el dato más elemental de todos: cómo nos llamamos.
Referencias normativas y técnicas
Reglamento marco. Reglamento (UE) n.º 910/2014 (eIDAS), en su versión modificada por el Reglamento (UE) 2024/1183 (eIDAS 2).
Actos de ejecución. Reglamentos de Ejecución (UE) 2024/2977 (PID y declaraciones electrónicas de atributos), 2024/2979, 2024/2980, 2024/2981 y 2024/2982 (primera serie, 28-XI-2024); 2025/846, 2025/847, 2025/848, 2025/849 y 2025/2162 (segunda serie, 2025); y la enmienda (UE) 2026/1731 (2026).
Architecture and Reference Framework (ARF). Annex 3.01 – PID Rulebook, dentro del conjunto del ARF y sus anexos (repositorio oficial de la Comisión Europea).
Formatos. ISO/IEC 18013-5 (mdoc) para la codificación CBOR/COSE; SD-JWT VC (IETF) para la codificación JSON con divulgación selectiva.
Te ayudamos
En EADTrust (European Agency of Digital Trust) acompañamos a las entidades obligadas a aceptar la Cartera Europea de Identidad Digital en su adaptación técnica y jurídica. El artículo 5 septies del Reglamento (UE) n.º 910/2014, modificado por el Reglamento (UE) 2024/1183 (eIDAS 2), impone esa aceptación a las administraciones públicas y a las partes usuarias privadas de sectores como el transporte, la energía, la banca y los servicios financieros, la seguridad social, la salud, el agua potable, los servicios postales, la infraestructura digital y las telecomunicaciones, además de a las plataformas en línea de muy gran tamaño (VLOP). Si su organización está entre ellas, podemos ayudarle a preparar la integración de la cartera con garantías de interoperabilidad y valor probatorio. Contacte en www.eadtrust.eu, info@eadtrust.com o en los teléfonos 902 365 612 y 91 716 05 55.
 Todo es electrónico
